
N8N 工作流使用 Crazyrouter API 教程
n8n 配置教程
在 n8n 中通过 Crazyrouter 配置 OpenAI 凭证、AI Agent 工作流与 HTTP Request 回退方案,并完成验证与排障
更新日期:2026-06-06
概览
OpenAI-compatible APIOpenAI API credential + 节点级 Base URLhttps://api.crazyrouter.com/v1sk-... tokengpt-5.5HTTP Request 节点直接调 Crazyrouter 接口。适合谁用
使用协议
OpenAI-compatible APIhttps://api.crazyrouter.com/v1https://api.crazyrouter.comhttps://api.crazyrouter.com/v1/chat/completions前置条件
| 项目 | 说明 |
|---|---|
| Crazyrouter 账号 | 先在 crazyrouter.com 注册 |
| Crazyrouter token | 建议为 n8n 单独创建一个 sk-... token |
| n8n | 建议使用当前稳定版,并确认 AI 节点可用 |
| 可用模型 | 至少放行一个当天已实测成功的聊天模型,如 gpt-5.5 |
gpt-5.5claude-opus-4-8gemini-3.1-protext-embedding-3-large(如果你会用向量或检索相关节点)5 分钟快速开始
创建 n8n 专用 token
n8n 的 token。首次建议只开放 gpt-5.5 和 claude-opus-4-8。添加 OpenAI 凭证
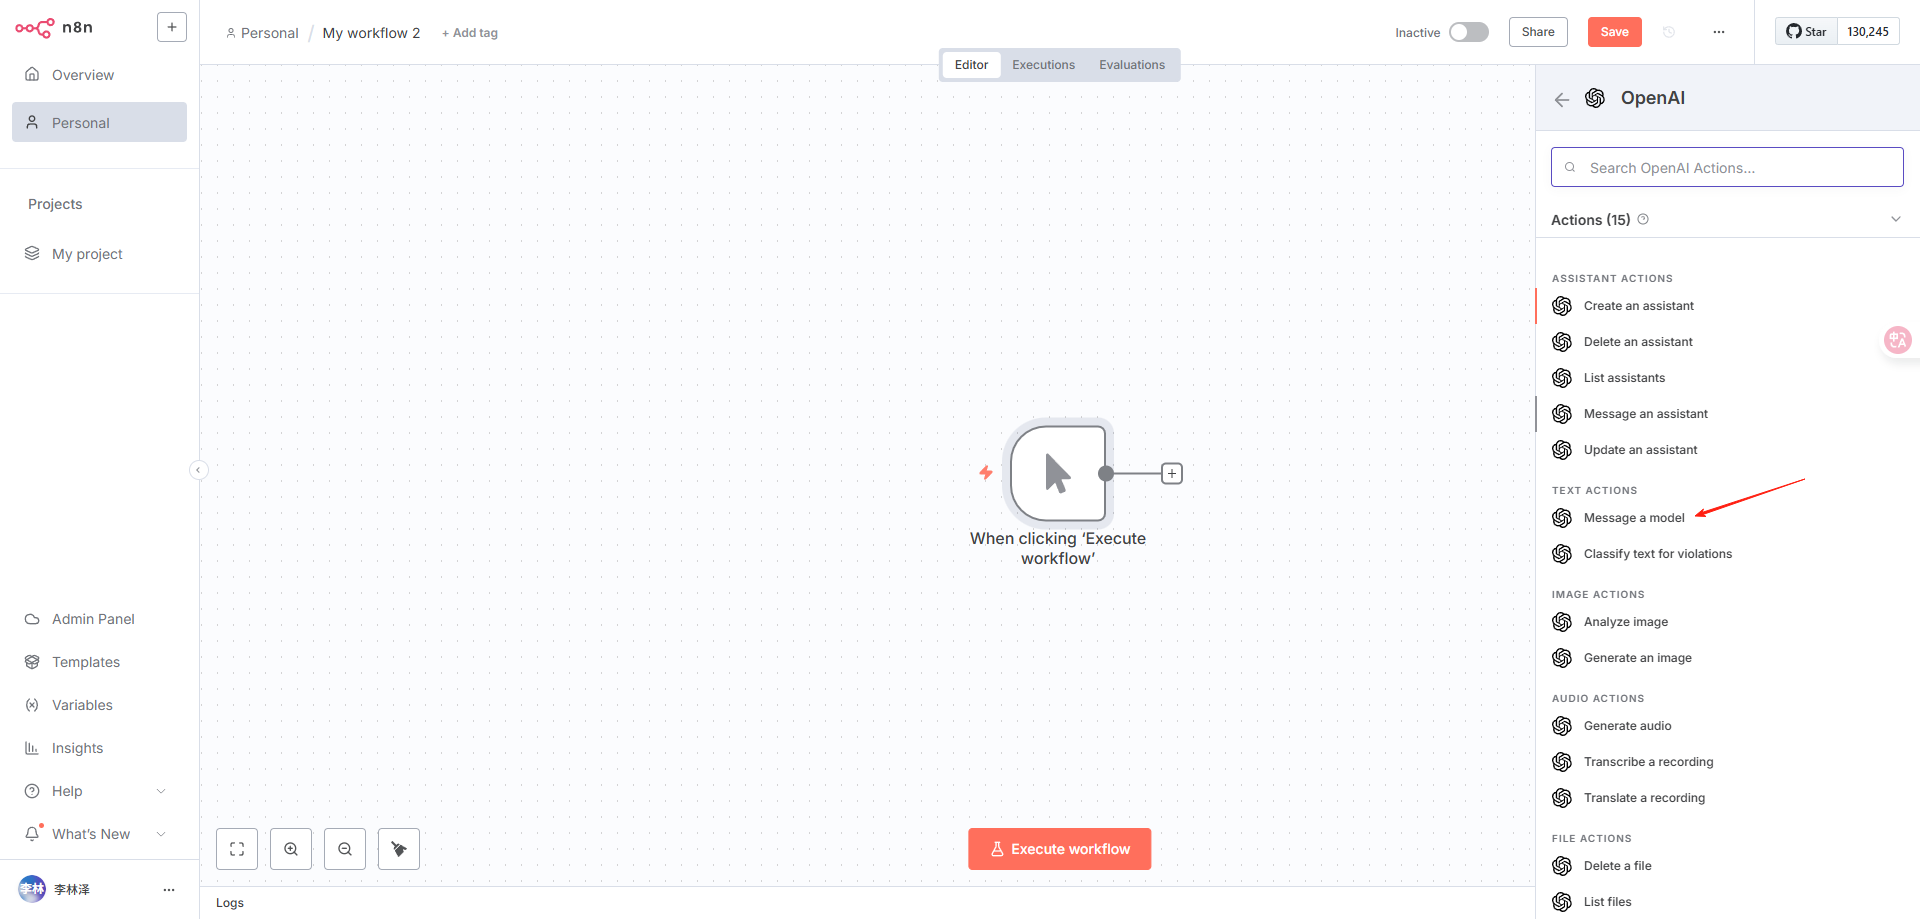
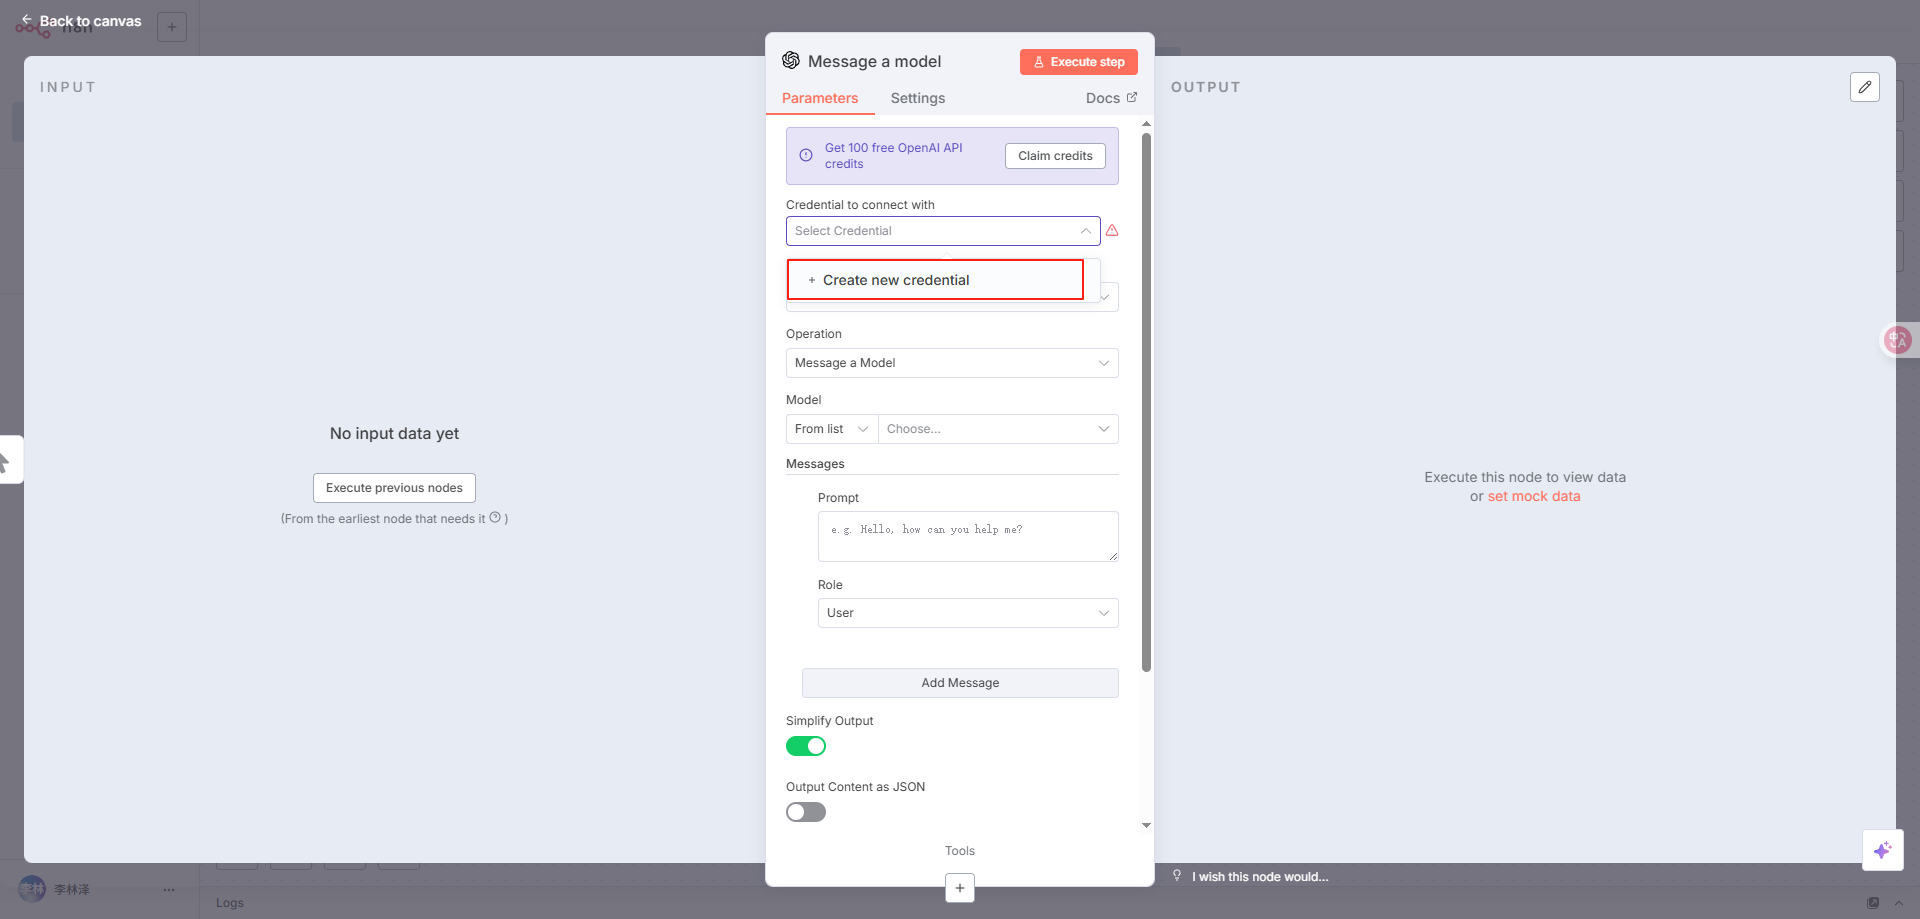
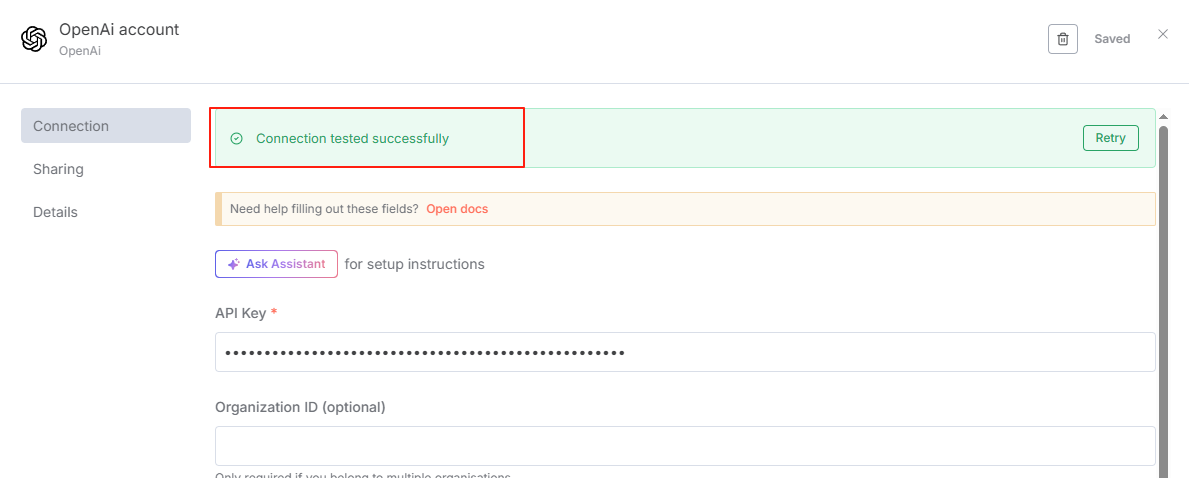
Settings → Credentials → Add Credential,选择 OpenAI API 或你当前版本对应的 OpenAI 凭证类型。填写凭证和节点信息
API Key: 你的 sk-...OpenAI、OpenAI Chat Model 或相关 AI 节点的 Options 中设置:Base URL: https://api.crazyrouter.com/v1创建最小工作流
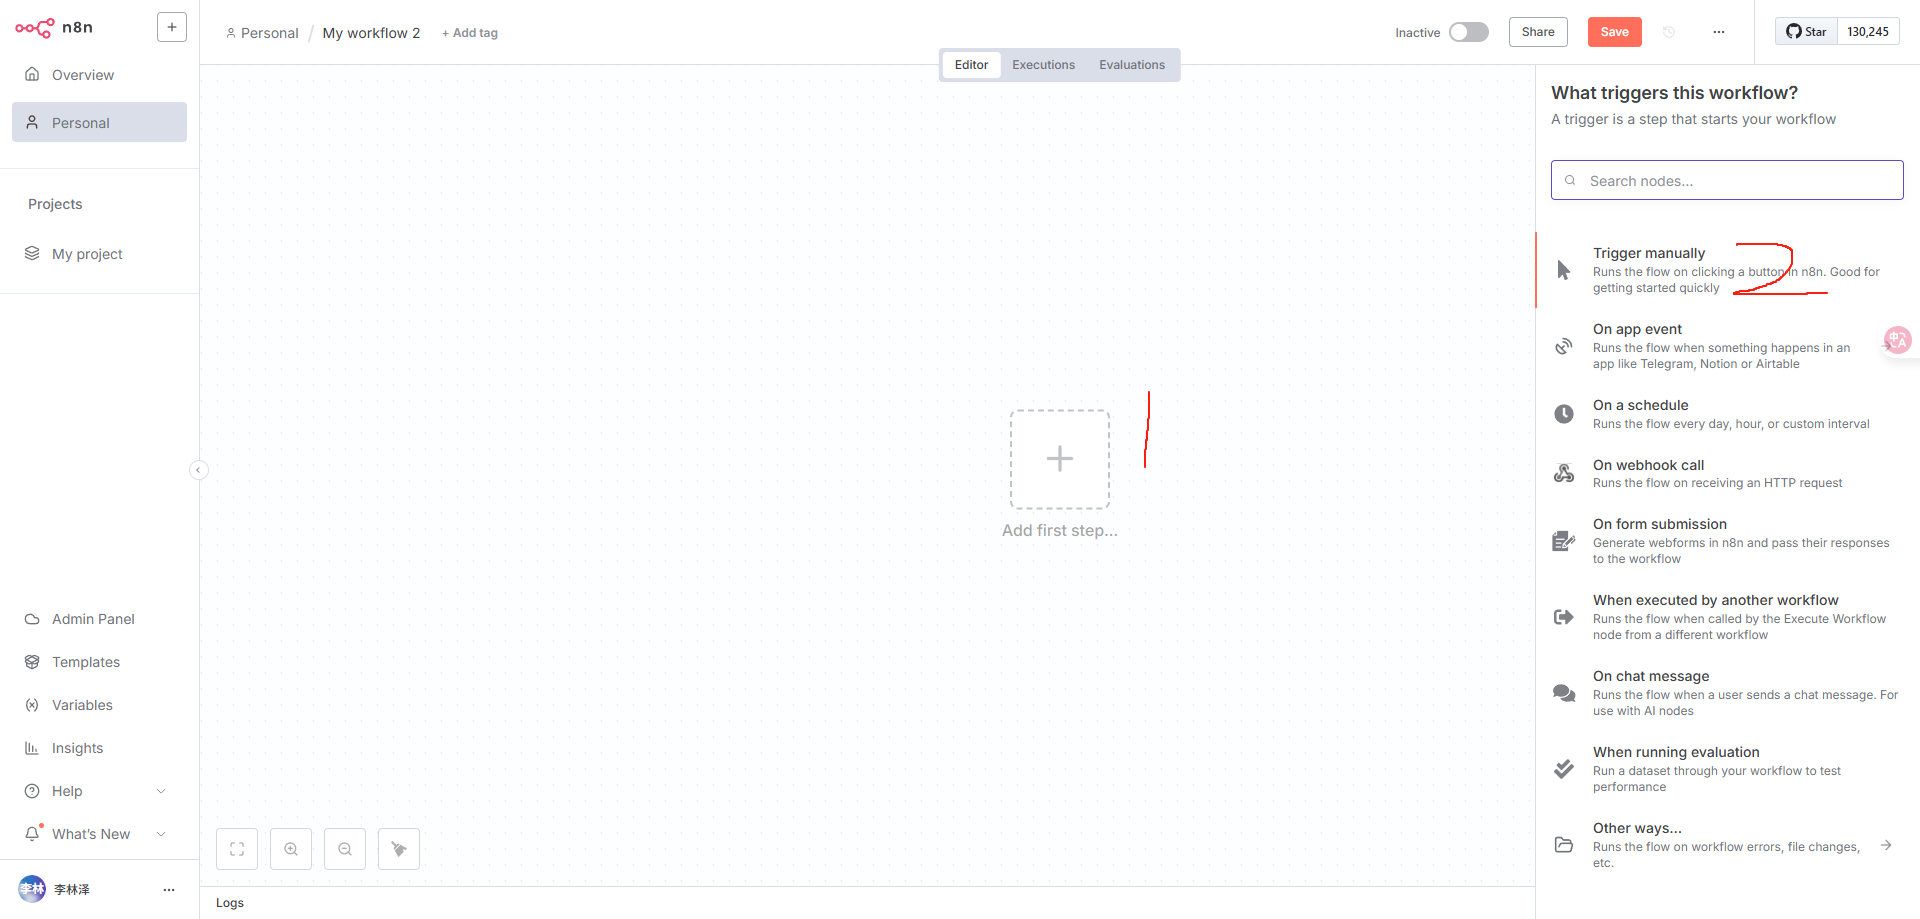
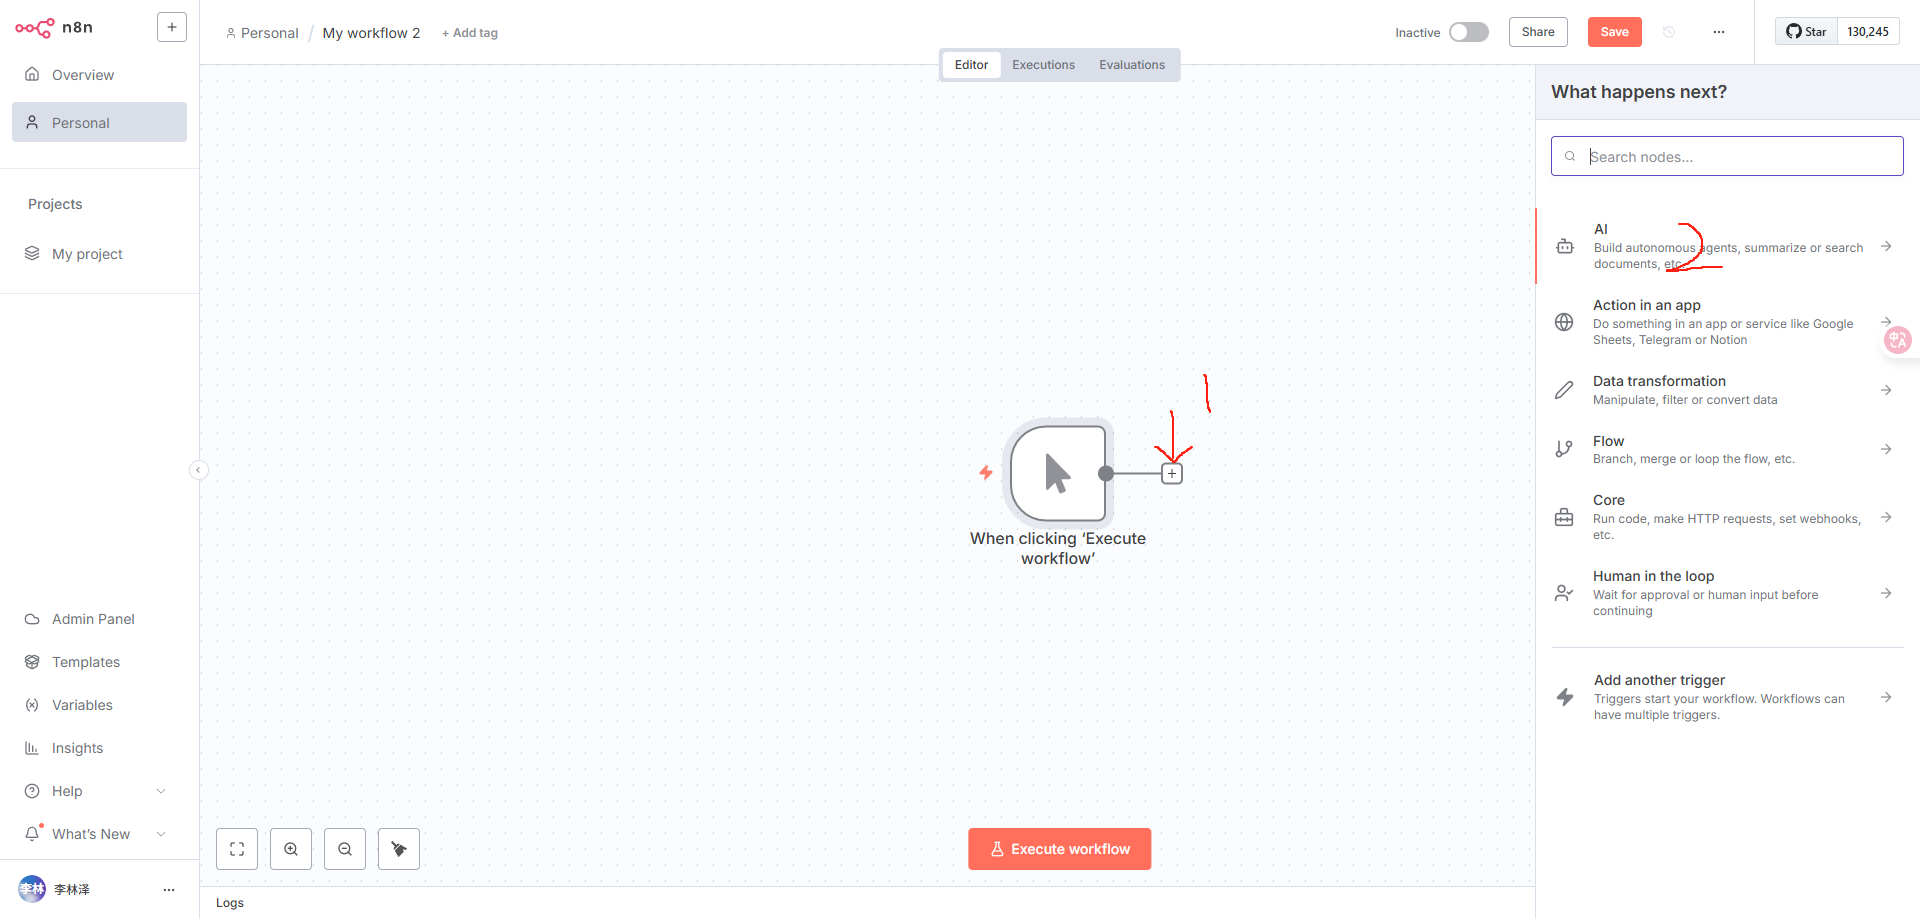
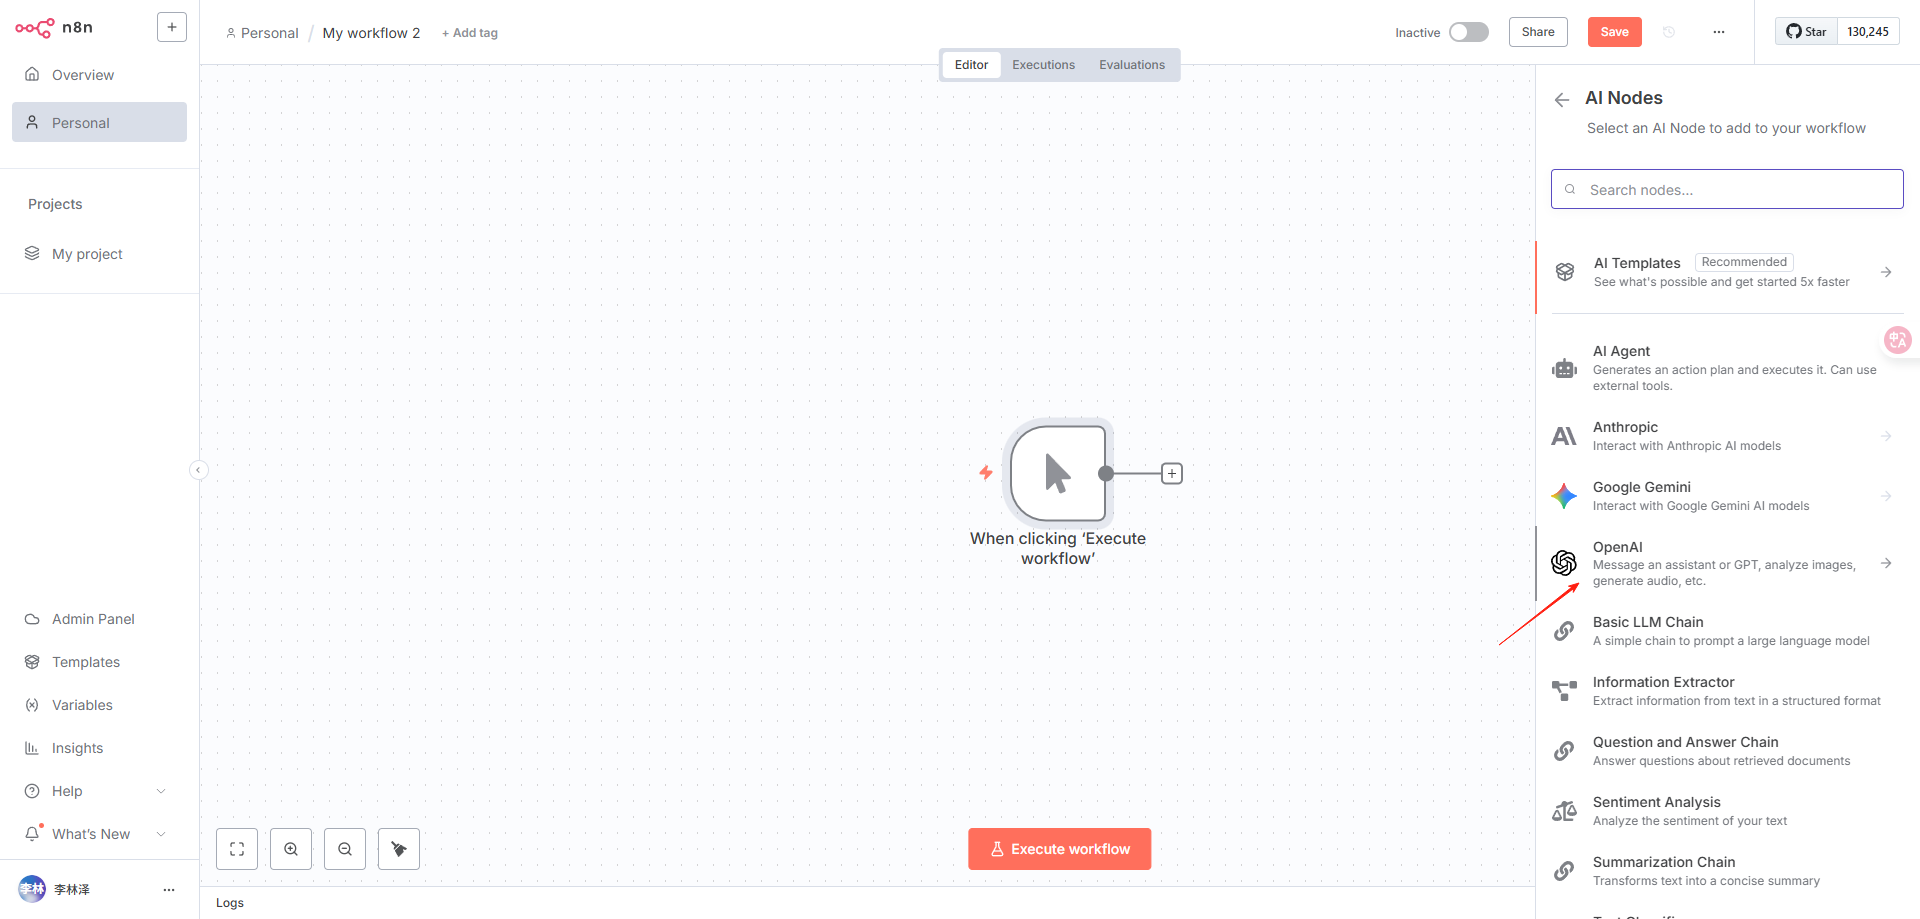
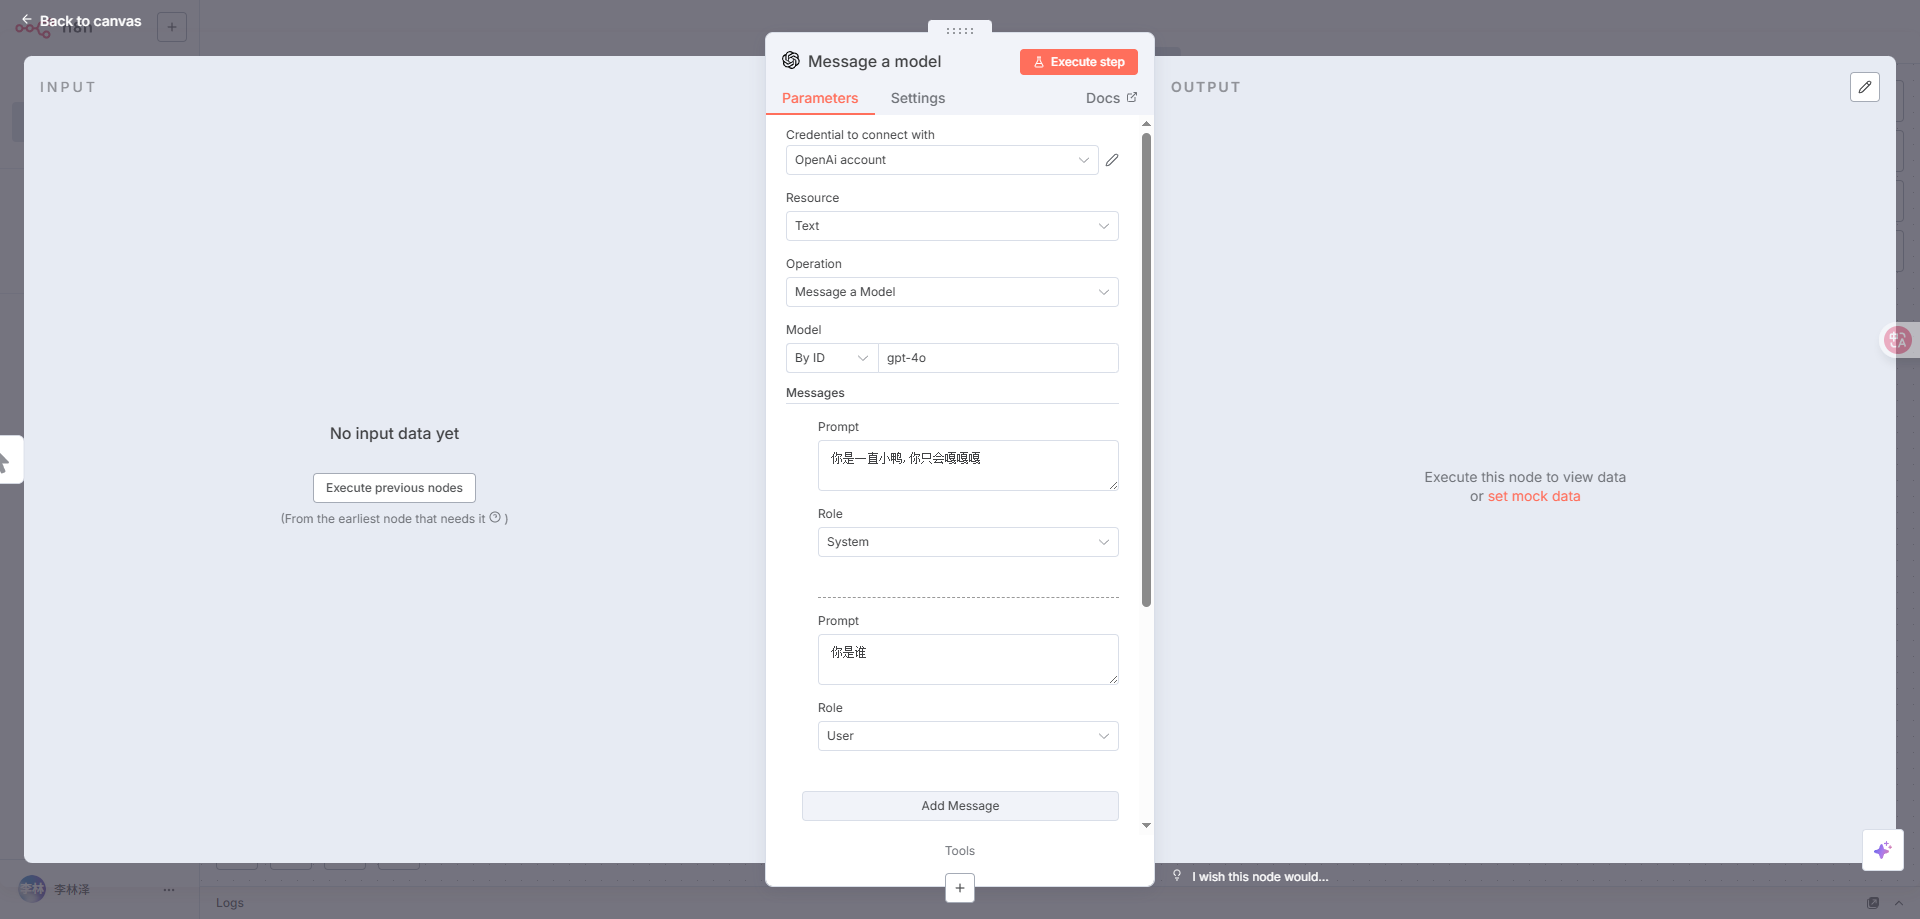
Manual Trigger → OpenAI Chat Model → Output,模型先填 gpt-5.5。完成首次验证
OpenAI Chat Model 节点里给一个简单输入,例如 Reply only OK,手动执行工作流。成功返回后,再继续配置 AI Agent 或复杂流程。最小工作流示例
OpenAI Chat Model 节点
{
  "node": "OpenAI Chat Model",
  "parameters": {
    "model": "gpt-5.5",
    "messages": [
      { "role": "user", "content": "{{ $json.input }}" }
    ]
  }
}
AI Agent 工作流
1.
Manual Trigger2.
AI Agent3.
OutputAI Agent 中选择刚创建的 Crazyrouter 凭证,并先只挂一个简单工具节点,避免把模型问题和工具问题混在一起。HTTP Request 回退方案
HTTP Request 节点调用 Crazyrouter:Tip: 推荐顺序是:先用 OpenAI 凭证 + 原生 AI 节点跑通;只有在节点能力不够时,再切到 HTTP Request。
Note: 不同 n8n 版本里, Base URL可能出现在凭证页,也可能出现在具体的 OpenAI / Chat Model 节点Options里。当前官方文档更明确提到的是节点级Base URL覆盖项,所以接 Crazyrouter 时优先按“凭证填 Key、节点填 Base URL”的思路配置。
推荐模型配置
| 使用场景 | 推荐模型 | 原因 |
|---|---|---|
| 默认工作流模型 | gpt-5.5 | 当天已实测成功,适合作为 n8n 主基线 |
| 高质量复杂 Agent 场景 | claude-opus-4-8 | 适合更复杂解释和长文本任务 |
| Gemini 备用档 | gemini-3.1-pro | 适合补充第二条兼容性验证路径 |
| 检索 / 向量相关 | text-embedding-3-large | 适合后续做向量处理或检索增强 |
gpt-5.5 跑通最小工作流,再扩展到 Agent、工具和批量任务。Token 设置最佳实践
| 设置 | 建议 | 说明 |
|---|---|---|
| 专用 token | 必须 | n8n 不要和聊天前端、CLI 或 SDK 示例共用 token |
| 模型白名单 | 强烈建议 | 只放行工作流真正会用到的模型 |
| IP 限制 | 固定服务器出口建议开启 | 本地调试、云端混用时谨慎使用 |
| 配额上限 | 强烈建议 | 自动化任务可能因为重试、循环、批处理快速消耗额度 |
| 环境隔离 | 必须 | 开发、测试、生产工作流使用不同 token |
| 节点分级 | 建议 | 高频任务用低成本模型,关键任务再切高性能模型 |
验证清单
OpenAI API 凭证已成功保存Base URL 已设置为 https://api.crazyrouter.com/v1OpenAI Chat Model 节点可正常执行AI Agent 节点也能正常调用模型常见错误与修复
| 现象 | 常见原因 | 修复方式 |
|---|---|---|
| 凭证测试失败 | API Key 错误,或把 Base URL 配置位置填错 | 重新检查 sk-...,并确认 Base URL 填在你的版本实际支持的位置 |
| 401 unauthorized | token 失效、被删或复制带空格 | 重新生成 token 并替换 |
| 403 / model not allowed | 节点中用到的模型不在白名单里 | 在 Crazyrouter 后台放行对应模型 |
| 404 | Base URL 填成根域名或完整接口路径 | 改成 https://api.crazyrouter.com/v1 |
| 工作流不停重试,成本快速增长 | 节点错误后自动重试、循环配置不当 | 限制重试次数,拆分工作流并设置额度 |
| AI Agent 能启动但工具调用不稳定 | 不是凭证问题,而是工具链路太复杂 | 先只保留一个简单工具节点做验证 |
| 原生 AI 节点缺少某些参数 | n8n 节点封装暂未覆盖该特性 | 改用 HTTP Request 节点直接调用 Crazyrouter |
| 批处理任务性能不稳 | 模型能力与节点封装不匹配 | 先回到 gpt-5.5 做最小链路验证,再扩展其他模型 |
性能与成本建议
gpt-5.5 做基线FAQ
n8n 里应该填哪个 Base URL?
https://api.crazyrouter.com/v1。Base URL 应该填在凭证里还是节点里?
Base URL 选项;如果你的凭证页也支持填写,填在那里也可以,但第一次配置建议以节点级设置为准。我应该先用原生 AI 节点还是 HTTP Request?
HTTP Request。第一个推荐模型是什么?
gpt-5.5。为什么工作流费用突然变高?
n8n 一定要拆多个 token 吗?
Note: n8n 接入 Crazyrouter 后,价值不只是“能调模型”,而是能把模型放进自动化链路里。因此最关键的不是单次对话能否成功,而是要同时控制重试、循环、批量执行和 token 配额。
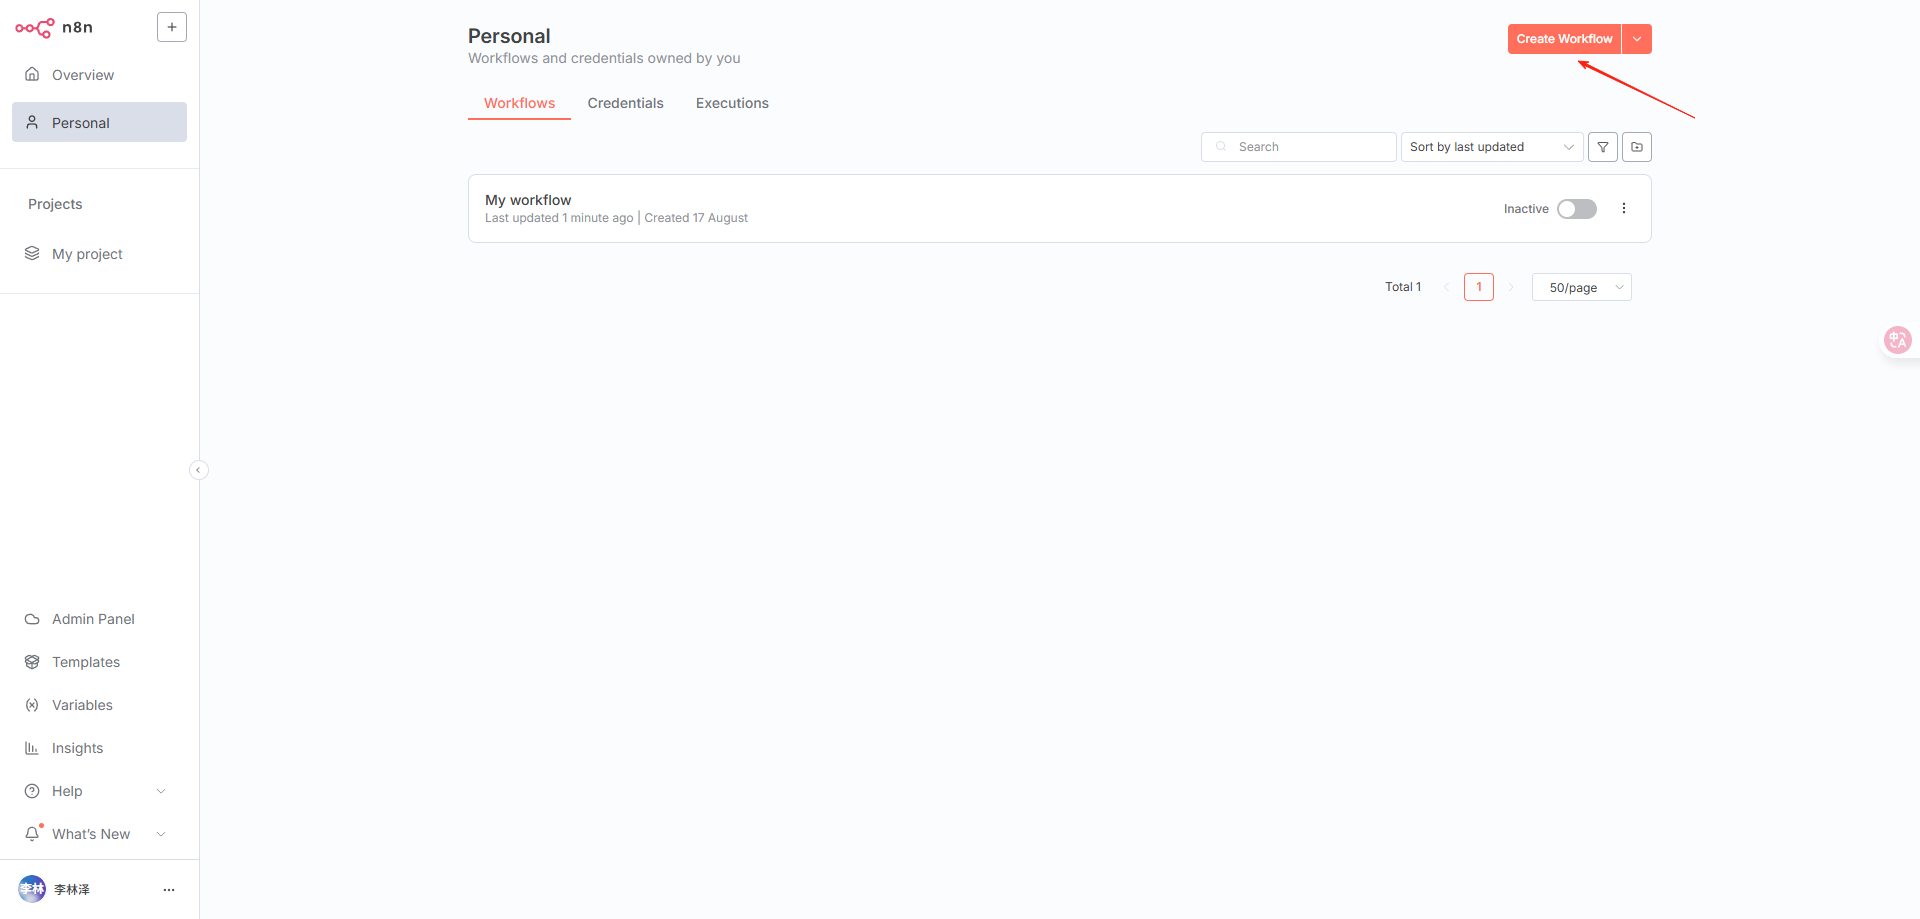
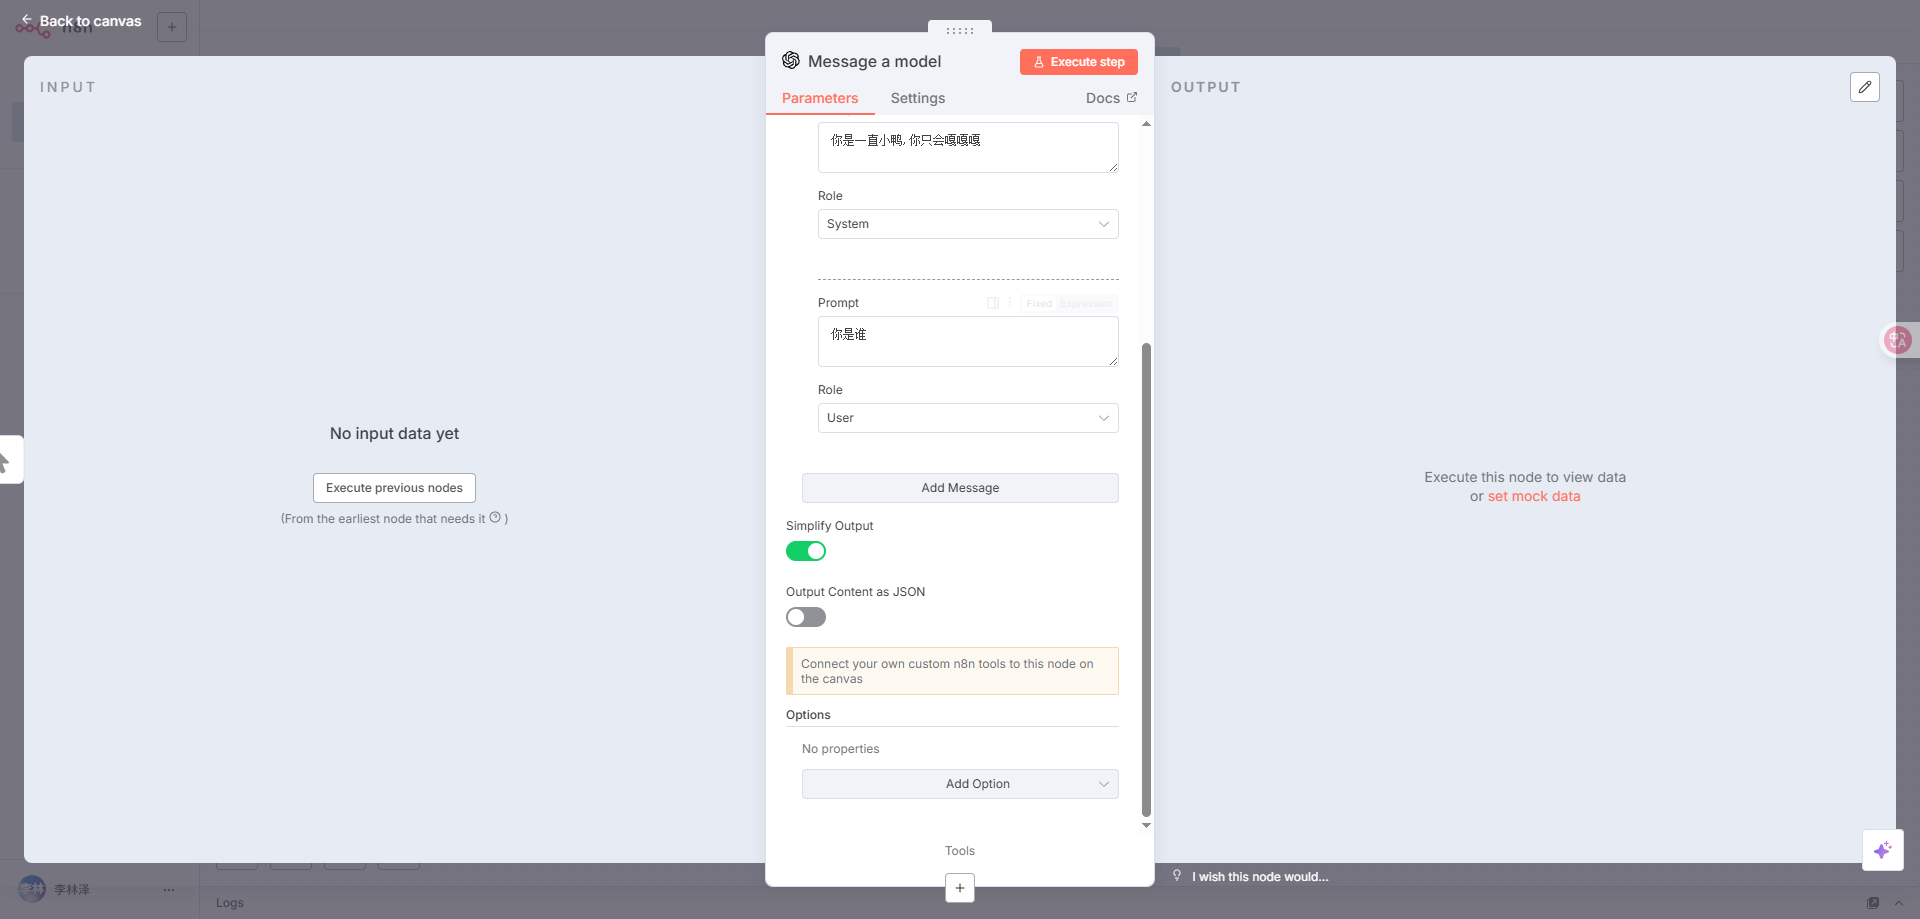
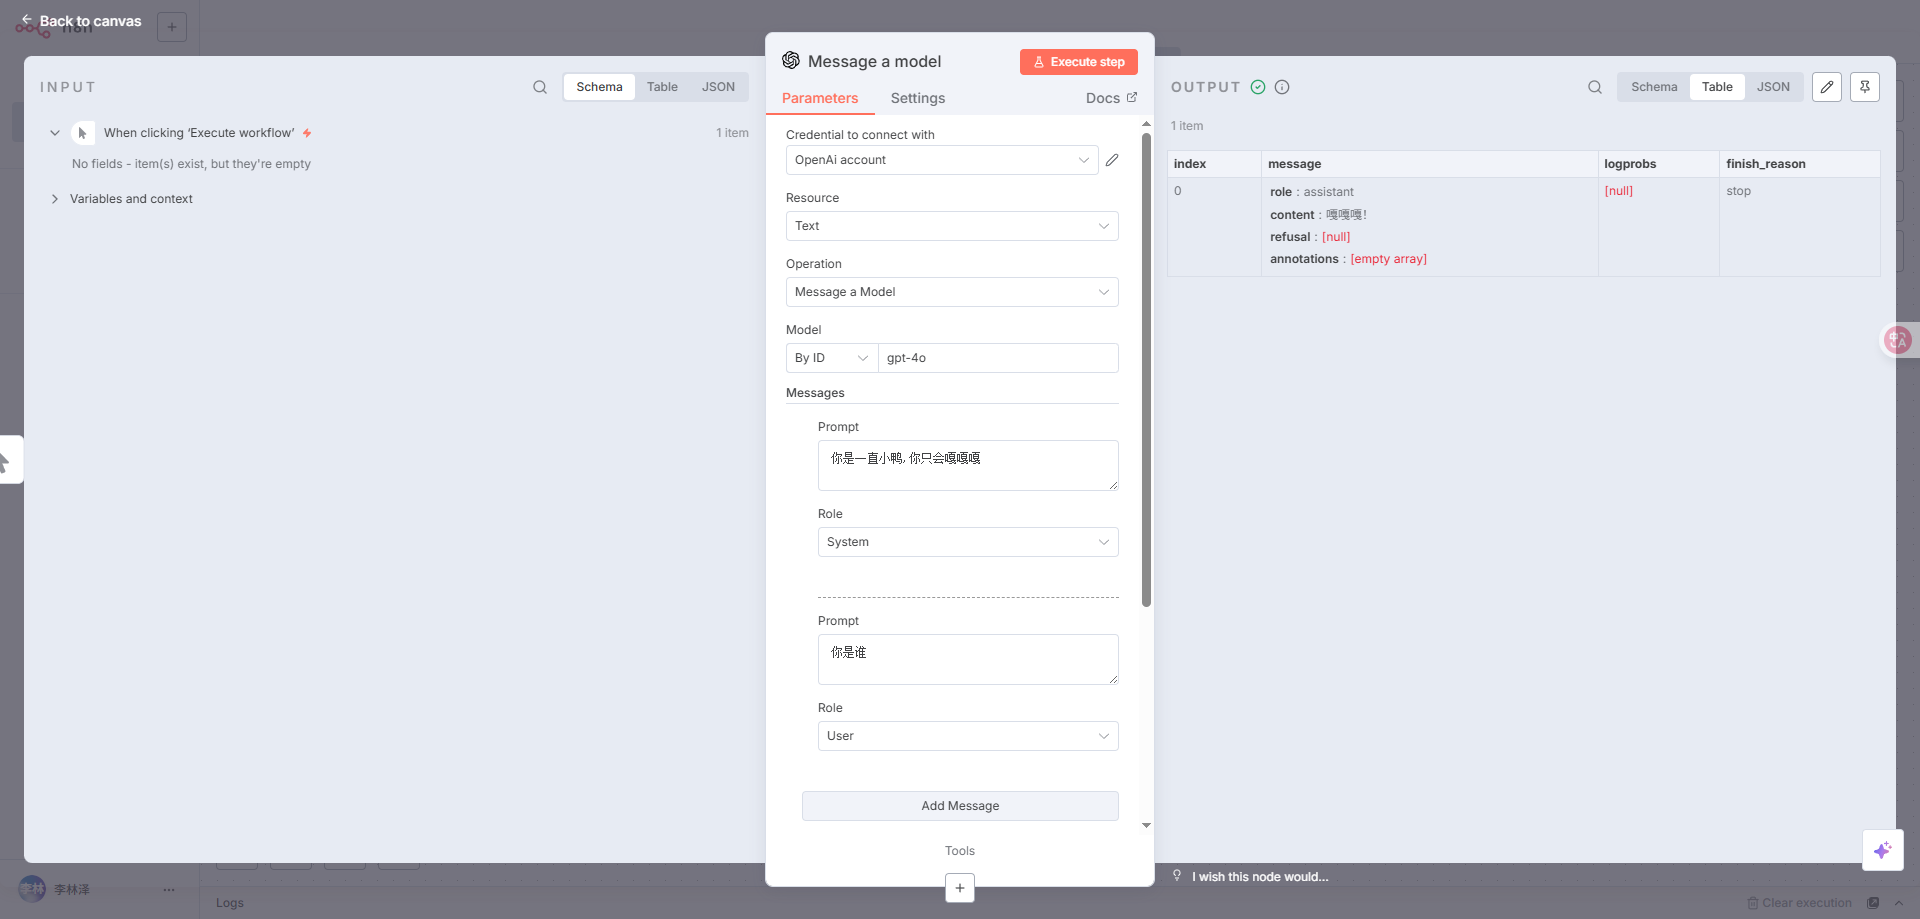
原教程截图
最后校验/修改:2026-09-28(API Base URL 由 cn.crazyrouter.com 统一改为 https://api.crazyrouter.com,共 9 处;账号/控制台仍为 https://crazyrouter.com)
Modified at 2026-09-28 13:06:28